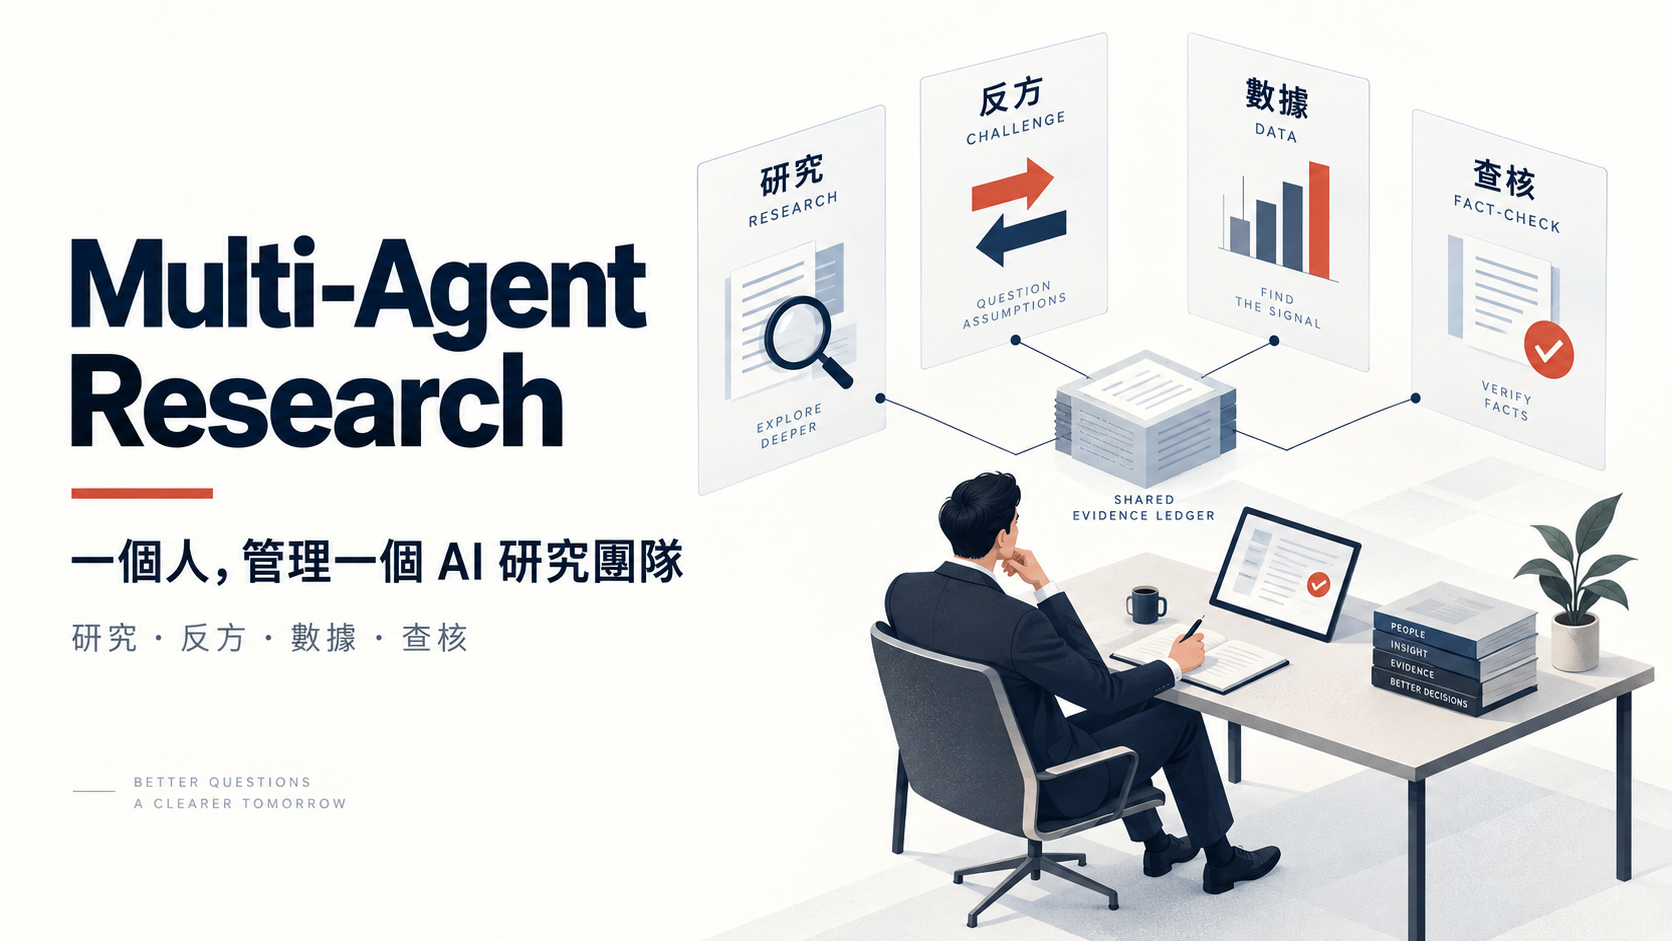
Multi-Agent Research ( 多智能體研究 )透過 AI Agent 分工 ,讓一個人建立 AI 研究團隊 與可追溯的 AI 研究流程 。研究、反方、數據與查核各有任務:蒐集來源、挑戰假設、核對數字、驗證證據,最後由人類主管整合結論並做出判斷。
先掌握三件事
- 人管問題:先訂研究範圍、決策用途與驗收標準,再分派工作。
- AI 管分工:研究與數據可先並行;反方取得初稿後挑戰,查核最後逐項驗證。
- 證據管結論:四個角色都同意,不代表有四份獨立證據。重要主張仍須回到原始來源。
一、Multi-Agent Research 是什麼?先理解適用範圍
這種研究方法把一個複雜問題,拆成有邊界、可交接的子任務。每個角色有自己的工作脈絡和輸出格式,管理者則負責整合。它特別適合資料分散、需要比較選項,或必須處理正反論點的題目。
Anthropic 公開的研究系統採用主控與研究子代理協作,並另外處理引文對應。這提供了分工與整合的實作參考,但本文的研究、反方、數據、查核四角色,是便於入門的教學設計,並非唯一標準架構。參見 Anthropic 的研究系統工程說明。
四個對話視窗,等於完整的多代理系統嗎?
不完全等同。四個獨立對話可以練習角色分工,但任務交接、版本管理與重跑仍由人操作。能夠使用工具、保存任務狀態、動態分派工作並反覆執行的系統,才更接近自動化的多代理研究。
初學者可先用人工協調的流程,確認方法有效,再考慮自動化。固定步驟的 workflow 與自主決定步驟的 agent 也有差別;這個區分可參考 Anthropic 對工作流程與代理的定義。
| 研究需求 | 建議起點 | 原因 |
|---|---|---|
| 整理一份已提供的文件、回答明確定義 | 單一 AI 加人工確認 | 資料與任務集中,交接的效益有限。 |
| 比較多個方案、整理市場或產業資料 | 研究與數據先分工 | 來源搜尋與量化整理可分開處理。 |
| 提案可能遭質疑,或來源互相矛盾 | 加入反方與查核角色 | 需要找反例、追溯證據與標記限制。 |
| 只想快速取得一句答案 | 先縮小問題 | 增加角色可能增加等待與閱讀負擔。 |
二、 AI Agent 分工 :四個角色各交付什麼?
有效的 AI Agent 分工 ,必須寫清楚「負責什麼、交付什麼、什麼算完成」。不要只替四個對話取名字,卻讓它們都做同一份摘要。
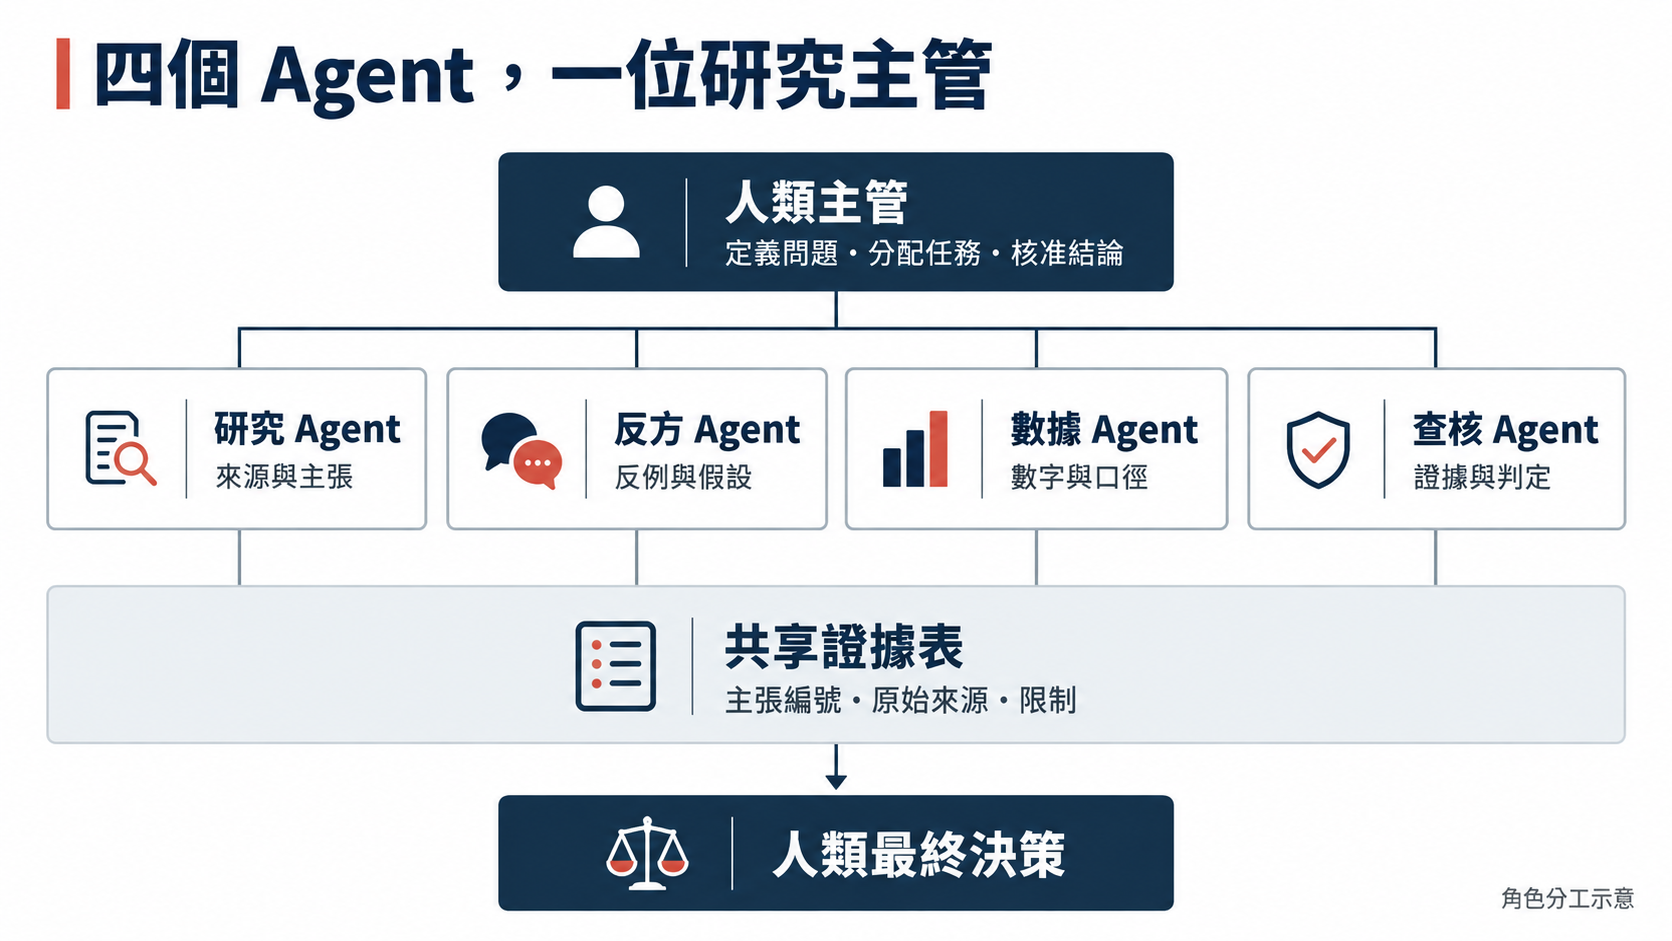
研究 Agent:建立問題地圖與來源清單
研究角色回答「目前有哪些可能的解釋?」先拆出子問題,再找與範圍相符的資料。優先檢視官方文件、原始調查與研究論文;二手文章可用來發現線索,但重要結論要回查。
交付物:問題樹、候選主張、原始來源連結、資料日期與缺口。每個主張加上編號,例如 C01、C02。不要把搜尋摘要直接當證據,也不要把找到的資料全部不加判別地堆進報告。
反方 Agent:挑戰假設與替代解釋
反方角色回答「什麼情況下,這個結論會不成立?」它應檢查因果跳躍、樣本偏誤、被忽略的族群和替代方案。目的在於提高判斷品質,無須為反對而反對。
交付物:主張編號、隱含假設、反例線索、需要補查的證據,以及什麼證據會讓它改變看法。Du 等人的多代理辯論研究在特定測試中發現改善,但這不代表任何角色辯論都能保證正確。
數據 Agent:確認分母、單位與可比性
數據角色回答「這個數字到底代表什麼?」除了找數字,也要記錄統計期間、地區、樣本、指標定義和計算方式。必要時使用計算工具或試算表重算,避免僅靠語言模型心算。
交付物:資料表、計算公式、原始值、單位、調查限制與缺漏。例如「比例增加 10 個百分點」和「相對增加 10%」意義不同,必須分開寫。調查發布年份也不一定等於資料涵蓋年份。
查核 Agent:逐一確認來源支持什麼
查核角色回答「這句話是否真的有依據?」它要開啟原始文件,對照段落、頁碼或表格,檢查引用是否越界。只確認網址能開啟,或比較三份 AI 摘要是否一致,都還不夠。
交付物:逐項查核表,將主張分為「採納、限定條件採納、待補查、不採納」,附理由與定位資訊。無法讀到全文、來源失效或資料不足時,必須明說無法驗證。
人類主管:對 AI 研究團隊 的結論負責
你負責定義問題、配置時間、設定證據門檻,以及裁決分歧。 AI 研究團隊 可以整理可選路徑,卻不能替你決定組織能承受的風險。最終報告應保留反方意見、適用條件與下一步,而非只留下最順耳的答案。
三、啟動 AI 研究流程 前,先寫研究任務書
一份好的任務書,可以減少跑題與重複搜尋。以下欄位由所有角色共用,之後再加各自的專屬指令。範例中的數量與時限是管理設定,請依題目難度調整。
研究任務書範本|Research Brief
決策問題:[這份研究要幫誰決定什麼?]
研究範圍:[地區、產業、對象、資料期間、截止日]
比較選項:[至少列出現況與替代方案]
評估標準:[效益、成本、可行性、風險等]
來源規則:[優先的一手來源;不採用的資料]
共同格式:[主張編號、證據、連結、定位、日期、限制]
任務邊界:[本次不回答的問題]
資源上限:[時間、搜尋輪次、工具使用上限]
停止條件:[哪些問題回答後即可定稿;哪些缺口須列待辦]
最終產出:[一頁摘要+證據表+分歧與下一步]
不夠明確:「幫我研究中小企業數位轉型。」
可以執行:「比較一家台灣服務業中小企業下一季應優先做員工訓練、流程整理,還是購買新系統;以成本、落地難度與可衡量效益為標準,列出支持與反對證據。」
不要在研究開始前,就要求 AI 證明某個選項一定最好。你也可以先要求反方獨立列出評估標準,等初稿完成後再審查,減少被第一份答案牽著走的機會。
四、Multi-Agent Research 六步驟:先並行,再交叉審查
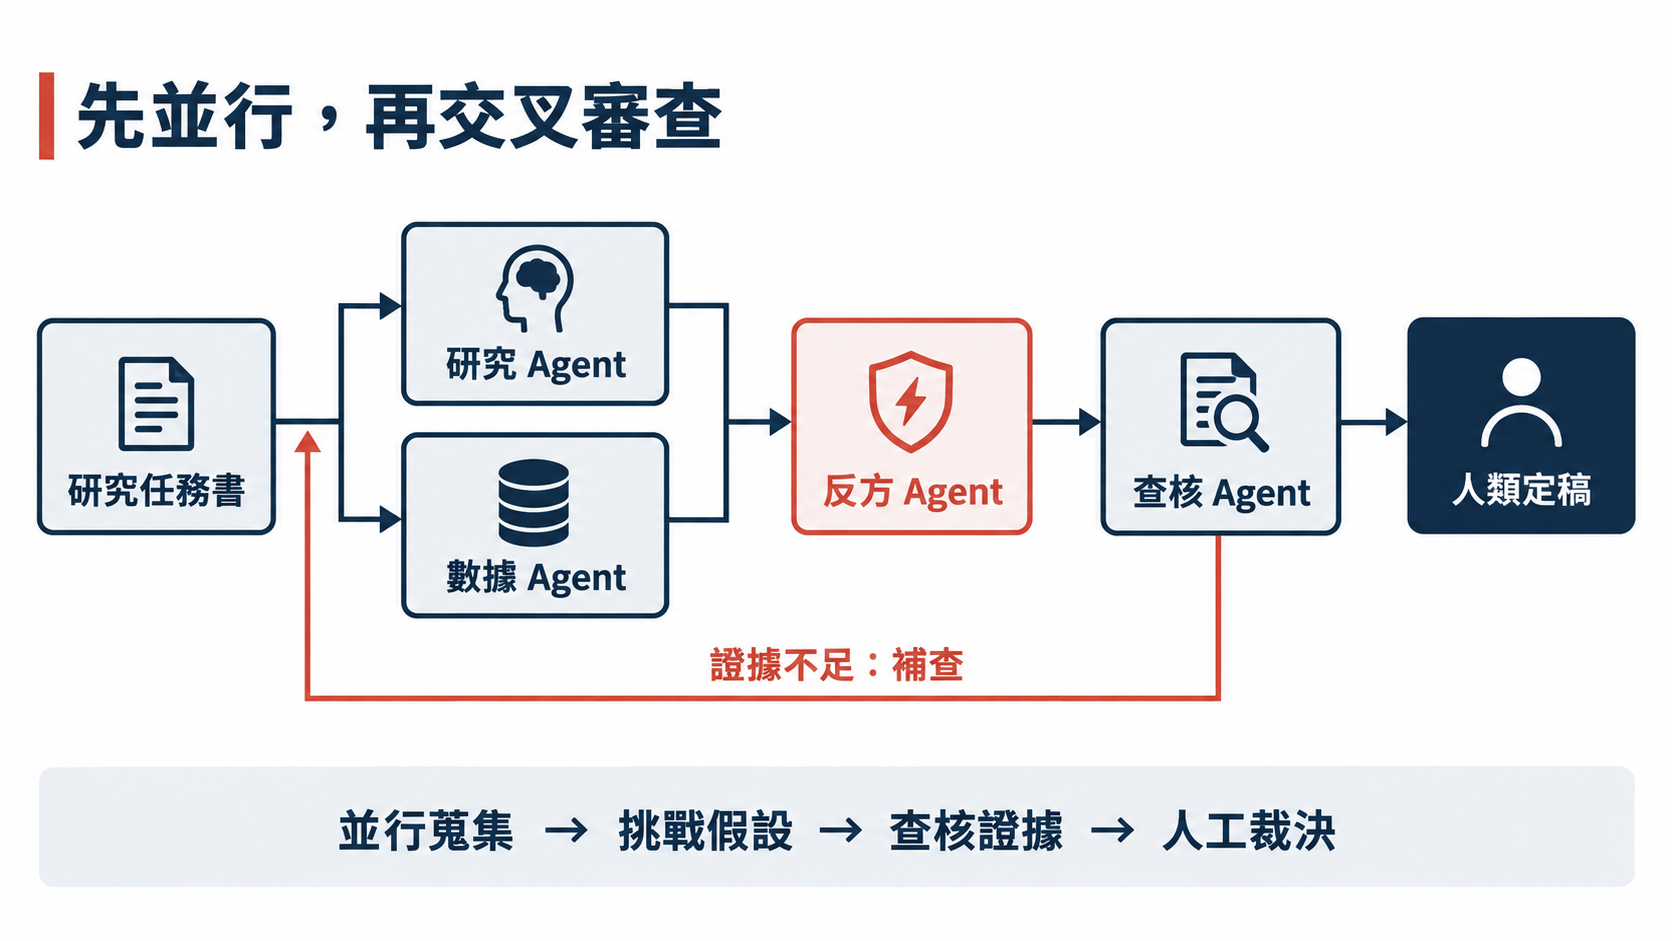
AI 研究流程 的順序很重要。研究與數據能同時蒐集資料;反方要看得到候選主張,查核則要取得完整來源。把四個角色一起啟動,並不表示四份輸出能直接相加。
步驟 1:界定決策與完成標準
寫好任務書,指定本次要回答的核心問題。再定義「完成」:例如每個建議都要有證據、適用條件與下一步;重要數字都能追溯。這是本次任務的門檻,不是通用的科學評分。
步驟 2:研究與數據各自蒐集
將相同任務書交給兩個角色。研究整理主張與來源,數據整理指標與口徑。兩者先保持獨立搜尋,避免只是互相轉述同一篇文章。交接時由主管統一主張編號;數據列另用 D01、D02,並對應 C01 等主張,避免編號碰撞或誤併。
步驟 3:反方逐項挑戰
把候選主張、證據表和資料缺口交給反方。要求它優先找「會改變決策的問題」,例如成本假設是否漏掉維護費,或成功案例是否只代表大型企業。每個反對意見也要附理由。
步驟 4:查核來源與數字
查核角色逐項比對原文、資料表與主張,確認同一來源是否被多次轉載。對於因果結論,特別檢查證據是否只有相關性;對於比例,確認分母及比較基準。
步驟 5:只重跑有缺口的任務
當 C03 的來源不足,就退回 C03 補查,不必讓所有角色重做一遍。標記版本,例如 v1、v2,保留「改了什麼、為什麼改」,避免舊結論被貼回新稿。
步驟 6:人類整合與定稿
最終摘要依序寫出:決策問題、建議、支持證據、反對意見、適用條件與下一步。未解決的衝突列入待辦;不要用投票把不確定性消失。這樣的 AI 研究團隊 才有可檢查的工作紀錄。
五、 AI Agent 分工 提示詞:四組可直接套用
先把共同任務書貼到每個獨立對話,再使用以下角色指令。方括號中的內容需自行替換;工具無法上網或讀取來源時,就要求它標記缺口,不得捏造引文。
研究提示詞|Research Agent
你是研究分析師。請依照上述研究任務書,把 [主題] 拆成可回答的子問題,優先搜尋一手資料。每項候選主張編號為 C01、C02,附來源名稱、網址、發布日期、資料期間、支持段落或頁碼,以及適用限制。區分已知事實、來源觀點與你的推論。最後列出尚未回答的問題。找不到或無法讀取的資料,請明確標記,不要生成不存在的來源。
反方提示詞|Devil’s Advocate Agent
你是反方審查員。請檢查 [候選主張與證據表],依主張編號列出隱含假設、最有力的反例、替代解釋及可能被忽略的對象。對每個異議說明:什麼證據會支持或推翻它?優先處理會改變決策的問題。不要為反對而反對;如果原論點有充分支持,請承認其成立範圍。請把需要補查的問題交回研究或數據角色。
數據提示詞|Data Agent
你是數據分析師。請依 [研究任務書] 整理關鍵指標。每筆數字列出原始來源、表格或頁碼、統計期間、地區、樣本、分母、單位和指標定義。涉及計算時使用可用的計算工具,展示原始值、公式與結果。不可直接合併不同口徑的資料,也不可把缺漏值當零。真實統計、估算與教學假設必須分開標記。最後說明哪些比較成立、哪些不能比較。
查核提示詞|Fact-Check Agent
你是獨立查核員。請檢查 [研究、反方與數據輸出],逐一開啟原始來源,確認原文是否支持對應主張。檢查時間、範圍、數值、引用定位和轉載重複問題。輸出欄位:主張編號/判定/證據定位/理由/修正建議。判定只使用採納、限定條件採納、待補查、不採納。無法開啟或沒有足夠證據時,不得宣告已查證。最後列出人類定稿前必須處理的分歧。
六、實作案例:台灣中小企業的數位轉型障礙
假設一位服務業主管要決定下一季先投入訓練、整理流程,還是購買新系統。以下是教學模擬,並非對台灣中小企業的實證調查結論。我們示範的是研究方法,以及如何避免從局部資料跳到全體判斷。
把「找障礙」改成「比較可選方案」
研究角色先拆出人才能力、流程清晰度、資料品質、工具整合與管理支持等候選面向。這些是待驗證分類;不能因為 AI 列出了五項,就認定它們已涵蓋所有原因。
數據角色同時尋找相關原始調查,也可整理企業已授權提供的匿名內部指標。對於單一企業的採購決策,內部流程觀察與試點結果,往往還需補在產業資料旁,避免把整體平均直接套用。
| 角色 | 輸入或發現 | 交付與處理 |
|---|---|---|
| 研究 | C01:員工能力不足可能阻礙工具導入。 | 找出支持來源,列出適用產業與尚待驗證的範圍。 |
| 反方 | 即使完成訓練,權責與流程不清仍可能讓導入停滯。 | 要求比較「訓練」與「先整理流程」的替代解釋。 |
| 數據 | 公司自願回饋者與全體員工的分母不同。 | 保留樣本限制,不能把回饋比例當成全體比例。 |
| 查核 | 檢查原始資料是否支持局部現象,並保留因果推論限制。 | 有局部支持才限定條件採納;否則維持待補查,安排試點驗證。 |
| 人類主管 | 仍需知道哪個方案更符合本公司情境。 | 安排小範圍試點,觀察完成率、重工與使用障礙。 |
一個數字,示範數據角色為何不能省略
假設內部測試有 20 人回覆,其中 8 人反映工具操作困難。計算是 8 ÷ 20 × 100% = 40%。這裡所有數字都是示範假設;它只表示這 20 位回覆者的情況,不能寫成「40% 的台灣中小企業員工不會使用數位工具」。
反方接著問:沒有回覆的人是否不同?查核則確認報告有沒有誤把樣本換成母體。最後,人類可以決定追加訪談或觀察實際任務,讓 AI 研究流程 產出的建議有可驗證的下一步。
七、管理 AI 研究團隊 :證據表、查核閘門與驗收
不要只保存四份長篇對話。用一張共享證據表串起主張、來源與修正,後續接手的人才能知道結論怎麼形成。 多智能體研究 的管理核心,是讓每個結論都能回到依據。
| 欄位 | 記錄內容 | 用途 |
|---|---|---|
| Claim ID/主張編號 | C01:一句清楚且可驗證的主張 | 讓各角色討論同一件事。 |
| Evidence/證據 | 來源名稱、連結、段落或頁碼 | 回到原文核對。 |
| Scope/口徑 | 時間、地區、對象、樣本與單位 | 限制推論範圍。 |
| Challenge/異議 | 反例、替代解釋、待補資料 | 保留尚未解決的爭點。 |
| Status/判定 | 採納、限定條件採納、待補查、不採納 | 決定是否進入正式報告。 |
| Owner/版本 | 負責人、查核日、版本與修正理由 | 防止過期資訊混回定稿。 |
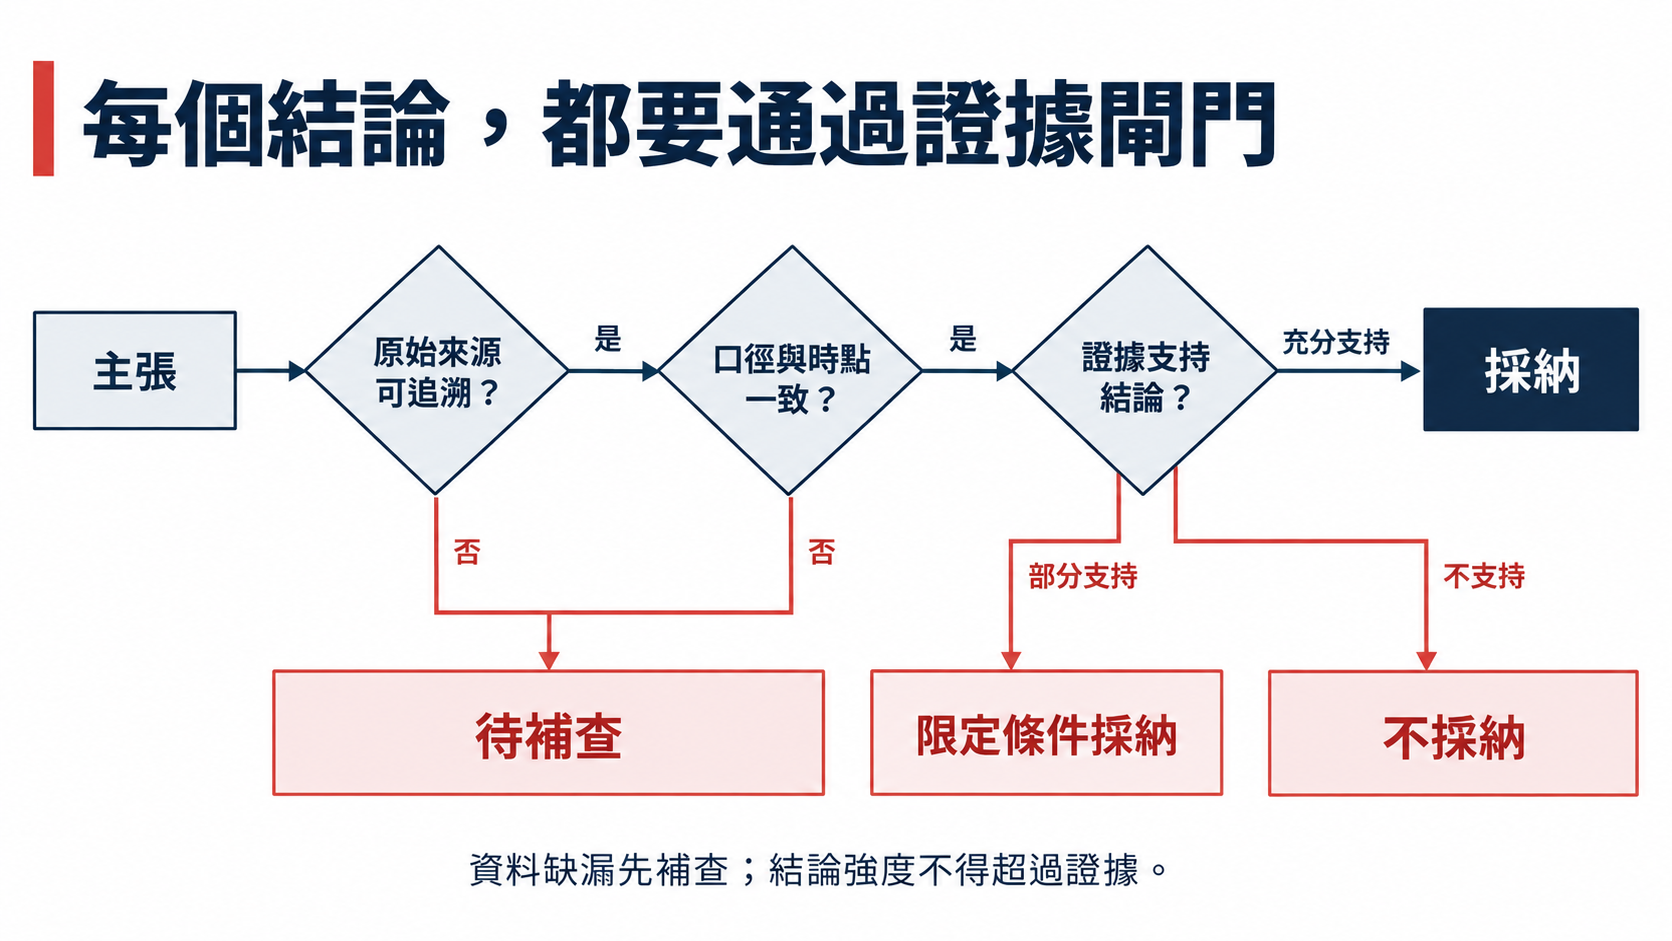
遇到結論衝突,依序做三件事
- 先對齊問題:兩份資料是否在說同一個期間、產業、對象與指標?若不同,拆開寫,不能直接平均。
- 再比對證據:回到原始調查或文件,確認多個網站是否只是轉載同一來源。來源數量不等於證據獨立性。
- 最後裁決:有充分支持才採納;只支持特定情境就限定條件;缺口會改變決策則補查;主張與證據不符則不採納。
AI 研究流程 的完成檢查清單
- 決策問題與研究範圍清楚,最終摘要有直接回答。
- 重要主張都有來源定位;推論、估算和假設有標記。
- 重要數字已核對公式、分母、單位和資料期間。
- 反例與替代方案已審視,未解分歧有明確負責人。
- 來源連結可用,且內容真正支持主張。
- 報告保留限制與下一步,由人類確認後定稿。
停止規則:若補查達到任務書設定的時間或輪次上限,仍無法解決關鍵缺口,就保留「待補查」,並說明它如何影響決策。不要為了完成報告而補出不存在的證據。
多智能體研究 常見的四種失誤
角色重疊:四個 Agent 做相同搜尋,交付物卻沒有差別。
過早共識:後續角色只改寫第一份摘要。
引用漂移:多次摘要後,原文的限定條件消失。
無限補查:沒有停止條件,成本與內容持續膨脹。
這些管理問題不能只靠增加角色解決。Cemri 等人的多代理失敗模式研究也指出系統設計、代理間協調與任務驗證的重要性。實務上,應先檢查 AI Agent 分工 與交接規則,再決定是否增加工具或角色。
八、從戰略自由度思考,展開選項再收斂
如果你熟悉戰略自由度(Strategic Degrees of Freedom,SDF),可以把「還有哪些可選路徑?」帶入任務設計。本文借用的是展開選項、檢驗條件、集中資源的教學思路;它不表示四角色架構源自 SDF,也不把 SDF 簡化為一套固定的 AI 操作步驟。
以數位轉型為例,先列出訓練、流程改善、工具整合與分階段試點,再讓研究角色找依據、反方挑戰假設、數據比較可衡量指標、查核確認證據。最後依組織限制決定下一步,而非讓 AI 自動選出看似最完整的方案。
想把問題拆解與方案比較用到工作現場,可延伸了解 HACC 戰略自由度工作坊,並以該頁公布的課程資訊為準。
九、Multi-Agent Research 常見問題
一個人真的能管理 AI 研究團隊 嗎?
可以從四個獨立對話與一張證據表開始。你需要管理任務書、交接與最後判斷。角色越多,閱讀與協調負擔也可能增加,因此先用一個範圍清楚的小題目練習。
多智能體研究 一定比單一 AI 準確嗎?
不一定。同一模型、相同來源或相似提示詞,可能產生相同盲點。分工的價值要透過來源查核、反例處理與實際驗收來確認,不能只看有多少角色同意。
AI Agent 分工 一定要用不同模型嗎?
不一定。同一工具的獨立對話也能練習分工。選擇模型與工具時,先看來源讀取、計算、資料處理與任務交接能力;不同模型的答案仍須查核。
建立 AI 研究流程 需要寫程式嗎?
入門不需要。先手動複製任務書與角色輸出,就能演練流程。當任務反覆出現、交接規則已穩定,再評估自動化;同時保留執行記錄與人工核准點。
反方與查核 Agent 有什麼不同?
反方檢查推理:假設合理嗎,有沒有替代解釋?查核檢查證據:來源是否存在,原文是否支持這句話?論證合理不等於資料正確,資料正確也不表示推論必然成立。
多久可以完成一輪研究?
取決於問題範圍、來源取得與證據門檻。可以先設定一個有時限的小型練習,但不應把固定分鐘數當成品質保證。無法處理的缺口應列入下一輪。
能直接上傳公司的內部資料嗎?
先確認組織授權、工具使用規範與資料範圍。練習時可用公開資料或已適當去識別的材料,僅提供完成任務所需內容。正式報告的最終使用仍由人類負責。
參考來源與方法說明
本文以公開工程說明與論文作為方法參考。四角色任務書、提示詞、證據表與模擬案例為本篇教學整理,並非來源作者對本篇流程的成效背書。資料查閱日期:2026 年 9 月 14 日。
- Anthropic(2025-06-13):How we built our multi-agent research system。主控、子代理協作、引文與管理成本。
- Anthropic(2024-12-19):Building effective agents。工作流程、代理與從簡單設計開始的原則。
- Du 等(2023):Improving Factuality and Reasoning in Language Models through Multiagent Debate。多代理辯論在特定任務的研究。
- Cemri 等(2025,v3):Why Do Multi-Agent LLM Systems Fail?。多代理系統失敗模式與驗證問題。